Desde hace un tiempo desarrollo Snowy, una aplicación meteorológica que reúne datos de muchos proveedores (estaciones, embalses, terremotos) y tiene un asistente al que se le pueden consultar esos datos y que genera resúmenes, informes y herramientas a partir de ellos. Empezó como un prototipo y no esperaba que llegara tan lejos. Hoy está en producción y en tres meses ha sumado más de 16 millones de impresiones en Google y más de 250.000 visitas desde el buscador.
Lo monté de la forma más rápida, con una sola aplicación de Next.js en Vercel. Con ese tráfico y las miles de páginas que genera, la factura pasó de 20 a casi 60 dólares en un mes, aunque tenía puestos límites de gasto y alertas.
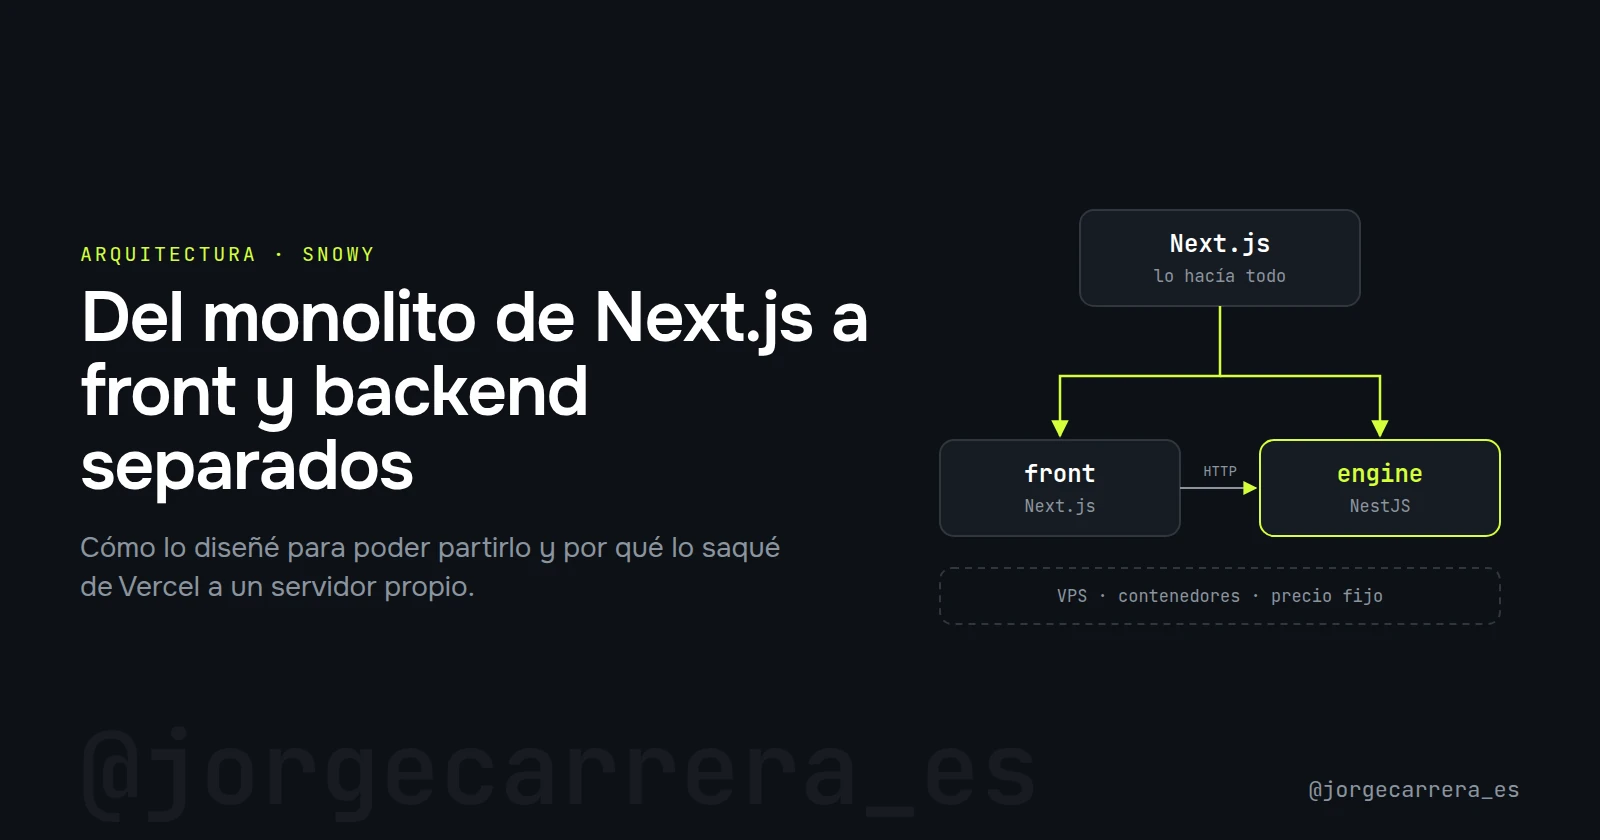
Así que decidí separar el backend del monolito y llevarlo a un servidor propio. Me tocaba configurarlo yo y poner Cloudflare delante para la caché y el control del tráfico y de los bots, pero el coste pasaba a ser fijo. Como Snowy sigue siendo un prototipo, eso me deja seguir sumando funcionalidades y nuevas aplicaciones sobre la misma base sin que la factura crezca al mismo ritmo.
El coste en Vercel
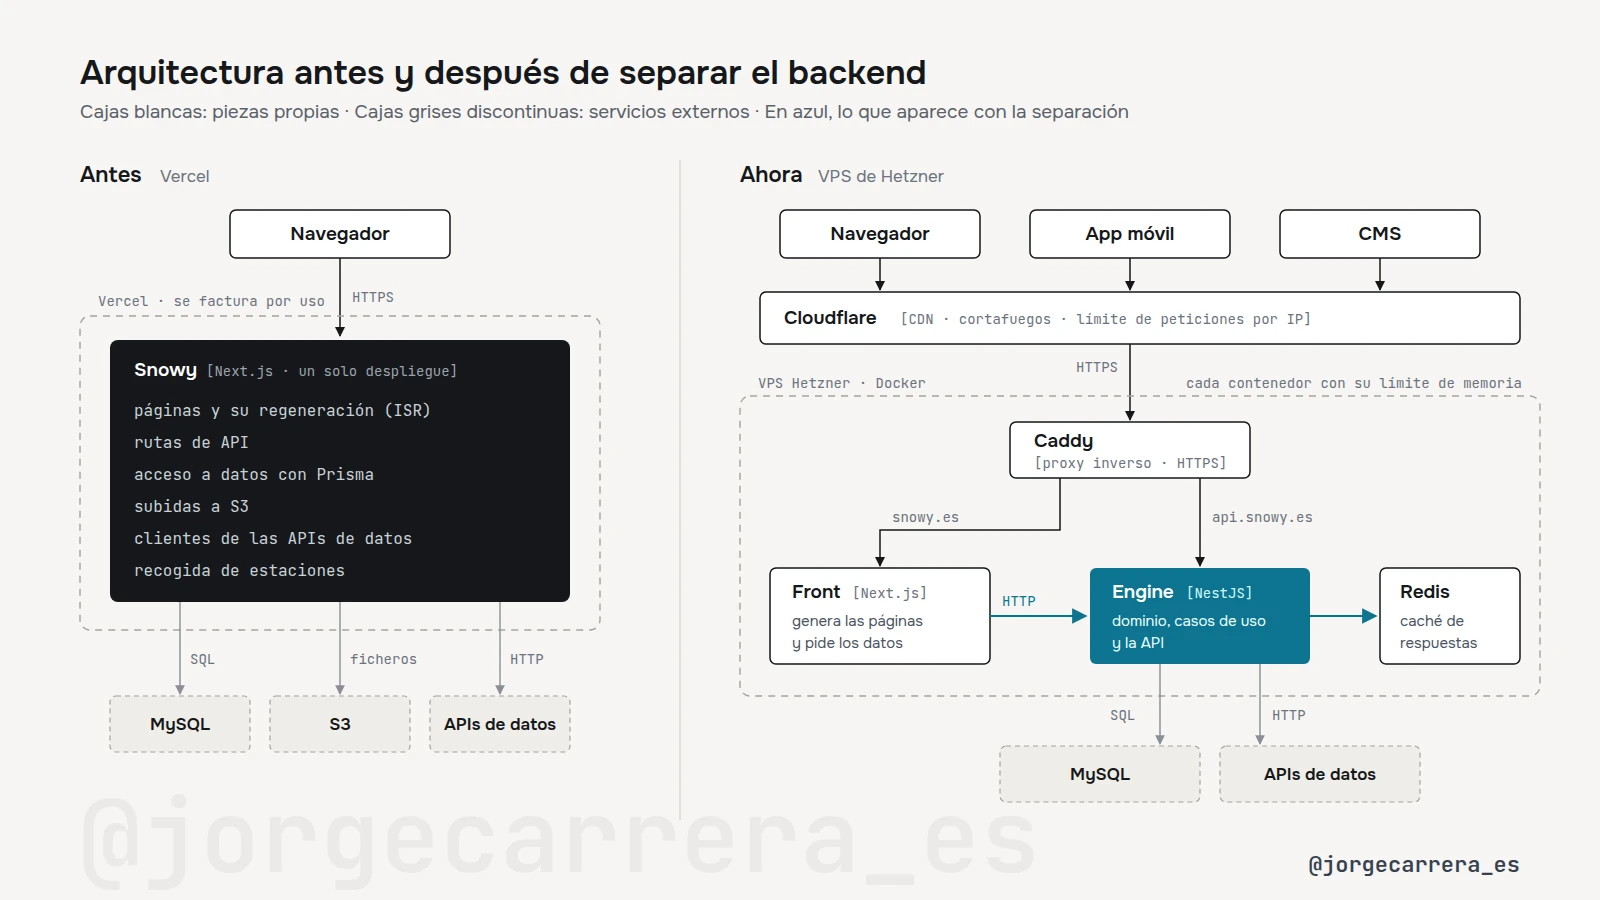
Vercel cobra el plan y, por encima, lo que consumes. Snowy tiene miles de páginas que Next.js regenera en segundo plano (ISR, incremental static regeneration), y cada regeneración cuenta como una escritura que, pasado el millón al mes, se paga aparte.
Lo primero que vi fue que los bots pedían ubicaciones inventadas, como /tiempo/lugar-inventado-xyz,
y la aplicación generaba una página nueva para cada una. Un mes sumó unos 3,75 millones de escrituras
de más. Lo frené cerrando el universo de ubicaciones que se pueden consultar a unas 16.000 conocidas.
Aun así, los costes seguían altos. Con el volumen de visitas de Snowy y la cantidad de páginas que se regeneran, las escrituras y el resto de consumos hacían inviable seguir en Vercel, al menos en una fase tan temprana del proyecto.
Arquitectura hexagonal y separación del backend
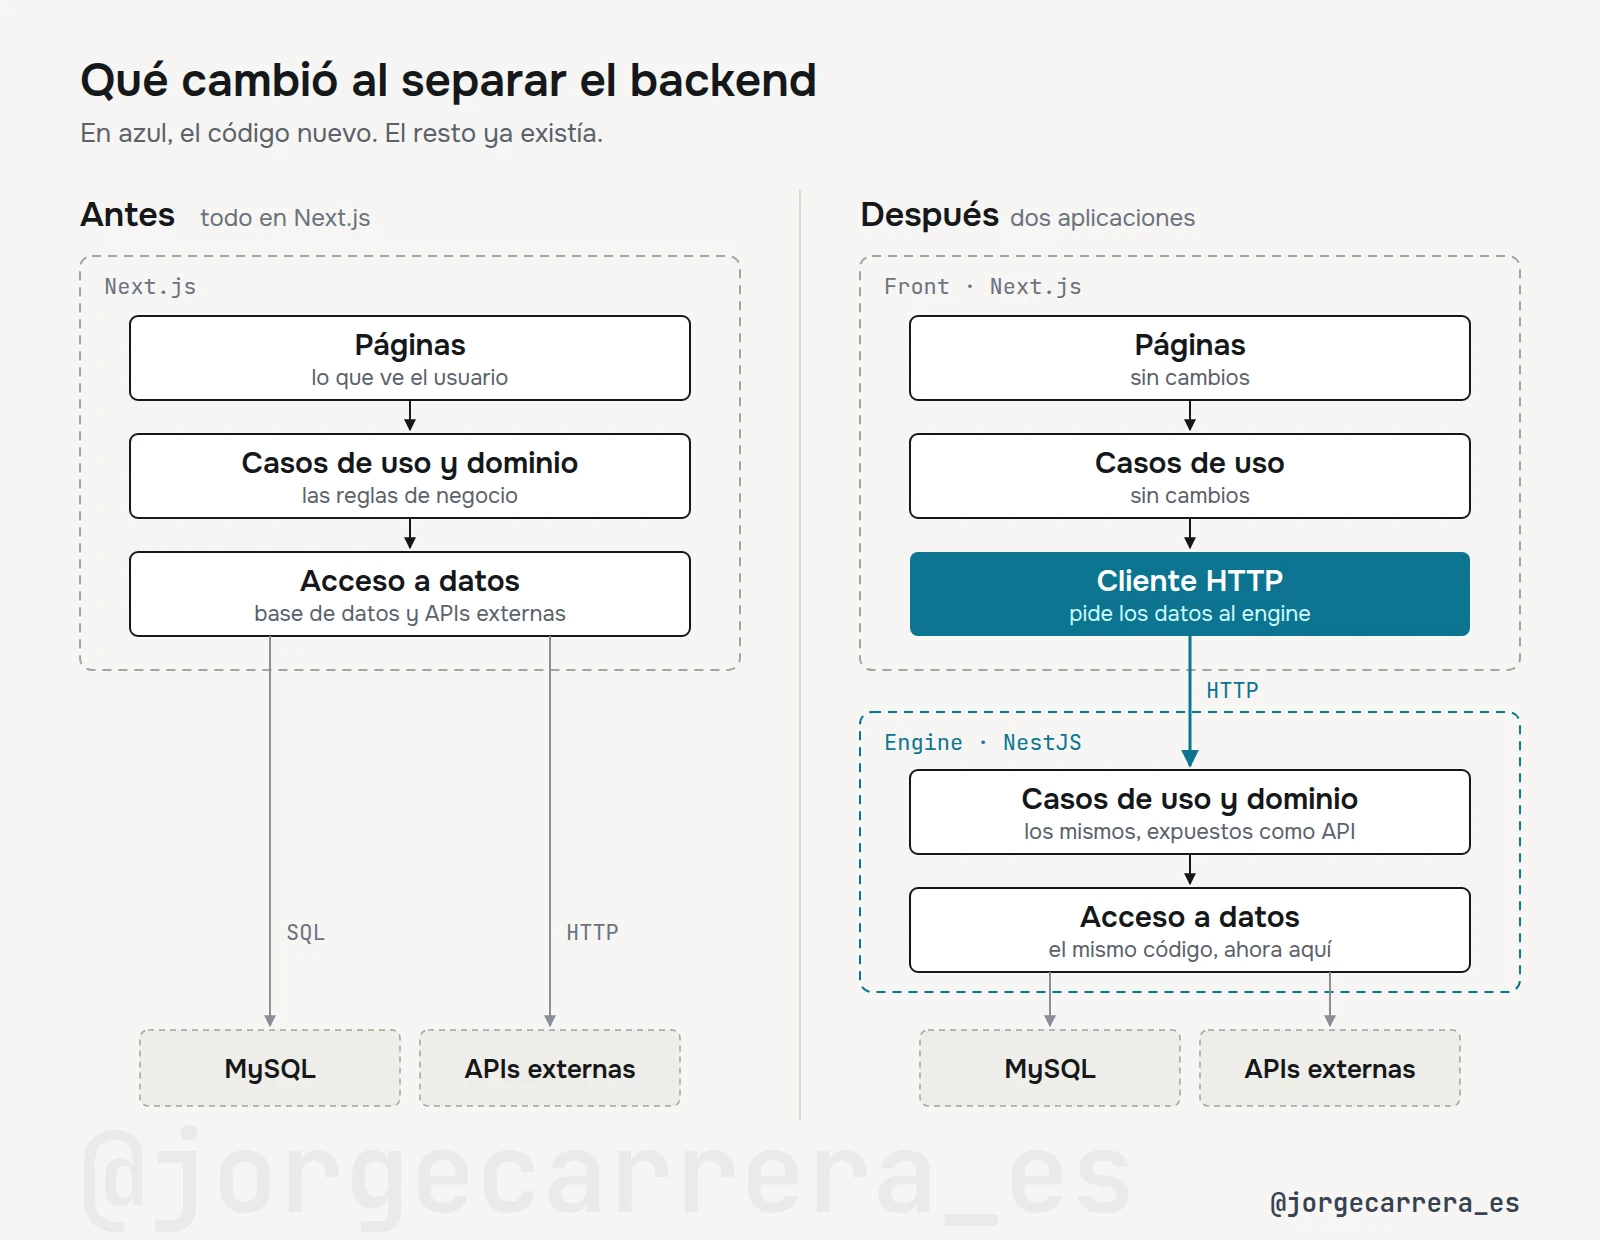
Desde el principio organicé el código con arquitectura hexagonal, contando con que algún día habría que separarlo. La idea es que la lógica de la aplicación no dependa de dónde salen los datos. Cada funcionalidad tiene tres capas:
- Dominio: las reglas de negocio.
- Aplicación: los casos de uso, que piden lo que necesitan a través de interfaces.
- Infraestructura: el código que cumple esas interfaces, ya sea consultando la base de datos o llamando a una API externa.
Un caso de uso pide, por ejemplo, los últimos terremotos, y no sabe si se los da la base de datos, una API u otro servidor. Eso se decide en un único fichero que conecta cada interfaz con su implementación. Es la inyección de dependencias.
Además de la factura, había otro problema. Con todo en una sola aplicación, cualquier cambio, fuera en las páginas o en la lógica de datos, obligaba a desplegarlo todo otra vez. Ahora cada parte se despliega por separado, y la web, el CMS y la app móvil usan la misma API.
El backend nuevo está hecho con NestJS, que trae módulos e inyección de dependencias de serie, la misma forma que ya tenía el código. Me llevé a él el dominio, los casos de uso y el código que toca la base de datos y las APIs externas, casi tal cual. El trabajo fue registrarlo en NestJS y exponerlo como endpoints, y portar casi todas las funcionalidades me llevó un día.
En el front, cada interfaz pasó a cumplirla una implementación nueva que pide lo mismo al backend por HTTP. Bastó con cambiar el fichero de dependencias, y los casos de uso del front siguieron igual. El front quedó como BFF (backend for frontend): genera las páginas y pide los datos al backend.
Infraestructura en el servidor
Delante va Cloudflare, que cachea, filtra el tráfico y limita las peticiones por IP. Dentro del servidor, Caddy recibe todo con HTTPS y reparte por dominio: la web al front y la API al backend.
El backend guarda en Redis las respuestas de los proveedores, cada una con la caducidad que pide su dato. Si muchas peticiones llegan a la vez a por lo mismo, solo una sale al proveedor. Y si el proveedor cae, se sirve la última respuesta buena.
Lo más importante fue poner un límite de memoria a cada contenedor. En un servidor compartido, un servicio que se desborda puede tumbar a los demás. Me pasó con el radar, el más pesado: en sus picos el sistema lo paraba a él solo, se reiniciaba, y la web seguía funcionando.
Con todo esto pasé de un coste variable, que empezaba a dispararse, a un coste fijo y bajo. Y el servidor va holgado.