Soy Jorge, ingeniero de software en Logroño. Trabajo como Tech Lead en proyectos de banca, colaboro como freelance con un cliente internacional y tengo varios proyectos propios en producción.
Desde hace más o menos un año, los agentes de IA generativa han ganado mucho peso en mi día a día como ingeniero. Yo sigo diseñando la arquitectura, revisando el código y tomando las decisiones de negocio, y el agente se encarga sobre todo del trabajo repetitivo que antes hacía a mano.
El problema era que todo lo que le explicaba al agente se acababa perdiendo. No lo retenía de una sesión a otra.
Sé que existen varios frameworks que resuelven parte de esto, y me sirvieron de base. Pero quería uno que cubriera todo lo que necesitan mis proyectos freelance y los personales, así que monté el mío.
La primera duda fue dónde guardar el contexto de cada proyecto. Documento mucho. Convenciones de código, decisiones técnicas, planes, decisiones de negocio en forma de ADRs. Y quería poder dejar una tarea a medias y retomarla otro día con todo el proceso guardado.
Junto al código no me convencía, porque llenaba los repositorios de ruido. Tampoco quería montar un RAG ni una base de datos, con lo que cuestan de pagar y de mantener. Y lo quería todo en la nube.
Hasta que caí en la cuenta de una cosa.
Un repositorio de git también es una base de datos.
Si cada proyecto tiene un repositorio solo para su documentación, al lado de los de código, el contexto queda versionado y en la nube, no cuesta nada más y es fácil de mantener y de entender, para mí y para cualquier agente.
Había un segundo motivo. Cada proyecto tiene sus reglas: una arquitectura
concreta, commits en inglés, código sin comentarios, ciertas verificaciones
antes de subir nada. Estaban escritas en el CLAUDE.md de cada repositorio y
aun así se las saltaban, los agentes y a veces también las personas, porque
nada lo impedía. Me faltaba algo que bloqueara las acciones que no siguen el
procedimiento.
Y al trabajar con varias tareas a la vez aparecían dos problemas más. Dos sesiones sobre el mismo repositorio mezclaban sus cambios en el mismo commit, y dos servidores de desarrollo se peleaban por el mismo puerto y la misma base de datos. Y el agente daba un trabajo por terminado sin haberlo comprobado: los tests pasaban, nadie había mirado la pantalla y él mismo escribía en el commit que estaba verificado.
Qué es crux
Crux es el kernel con el que trabajan mis agentes. Se instala una vez en el ordenador y todos mis proyectos dependen de él. Marca el ámbito en el que se mueve un agente: dónde está la información de cada proyecto, qué pasos sigue una tarea de principio a fin y qué tiene que comprobar antes de dar nada por terminado. El agente trabaja dentro de ese marco y no puede saltárselo por su cuenta.
Para eso tiene tres piezas:
- Un estándar que dice cómo se organiza la documentación de cada proyecto.
- Un conjunto de skills, procedimientos escritos para las tareas que se repiten.
- Un comando,
crux, que hace cumplir las reglas y no deja seguir si falta un paso.
Lo empecé en agosto y lo llamé crux, que en escalada es el paso clave de una vía, el que decide si la subes o no. Funciona con Claude Code y con Codex, lo usan seis proyectos, lleva 208 commits y va por la versión 0.53.
Tres capas
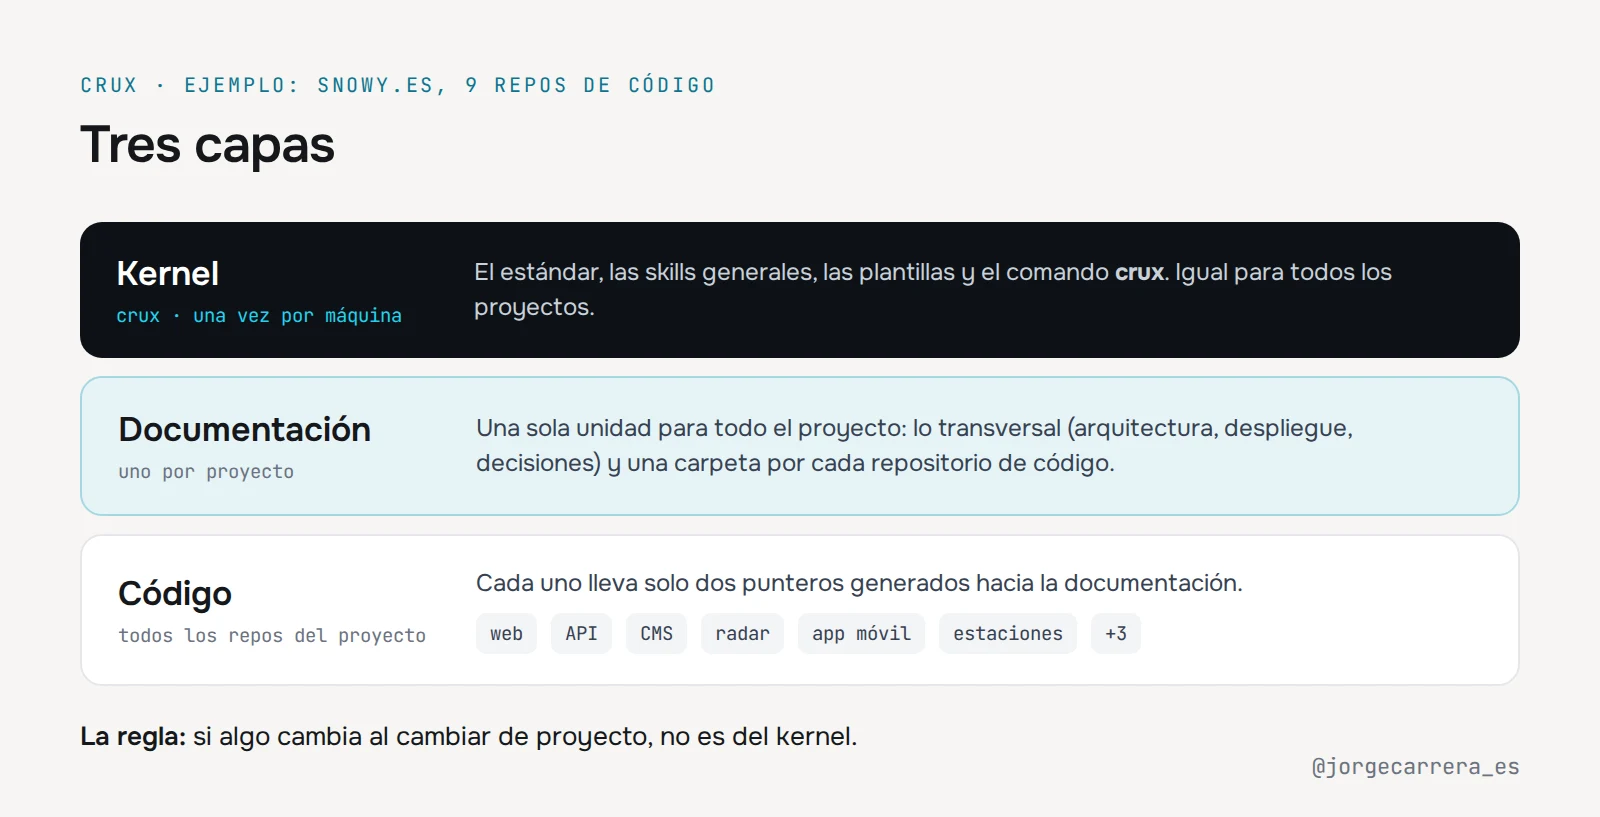
El kernel tiene lo que es igual en todos los proyectos. Cada proyecto tiene su
repositorio de documentación: cómo se despliega, qué hay construido, qué se
decidió y por qué. Y cada repositorio de código solo lleva dos ficheros cortos,
AGENTS.md y CLAUDE.md, que crux genera y que llevan al agente hasta esa
documentación. Para decidir dónde va cada cosa hay una sola regla: si cambia al
cambiar de proyecto, no es del kernel.
Un repositorio de documentación agrupa todos los repositorios de código de un
proyecto. En Snowy, la plataforma meteorológica en la que
trabajo, son nueve: la web, la API, el CMS, el generador del radar, la app
móvil, el plugin de WordPress y los procesos que recogen los datos de las redes
de estaciones meteorológicas. No tendría sentido mantener nueve repositorios de
documentación. Todos cuelgan de uno, snowy-docs, que funciona como una sola
unidad lógica. Dentro, cada repositorio de código tiene su carpeta con lo que es
solo suyo, y al lado está lo transversal: la arquitectura que los une, cómo se
despliegan y las decisiones que afectan a varios a la vez.
Con mi marca personal hago lo mismo. Su repositorio de documentación agrupa la web, el blog y las herramientas de mi cuenta de X, y cada proyecto nuevo que sale de ahí entra como una carpeta más.
Cada proyecto declara su configuración en un fichero, crux.json: qué
repositorios tiene, qué se comprueba antes de un commit y cómo se despliega.
Principios
De ahí salen dos reglas de fondo:
- Un inventario de lo que ya existe. Cada proyecto tiene uno, con lo que hay de cara al usuario, y el agente lo lee antes de proponer nada para no construir otra vez lo que ya está hecho.
- Código y documentación, en el mismo turno. Si cambio el código y no la documentación, el siguiente agente trabaja con información desactualizada.
El ciclo de una tarea
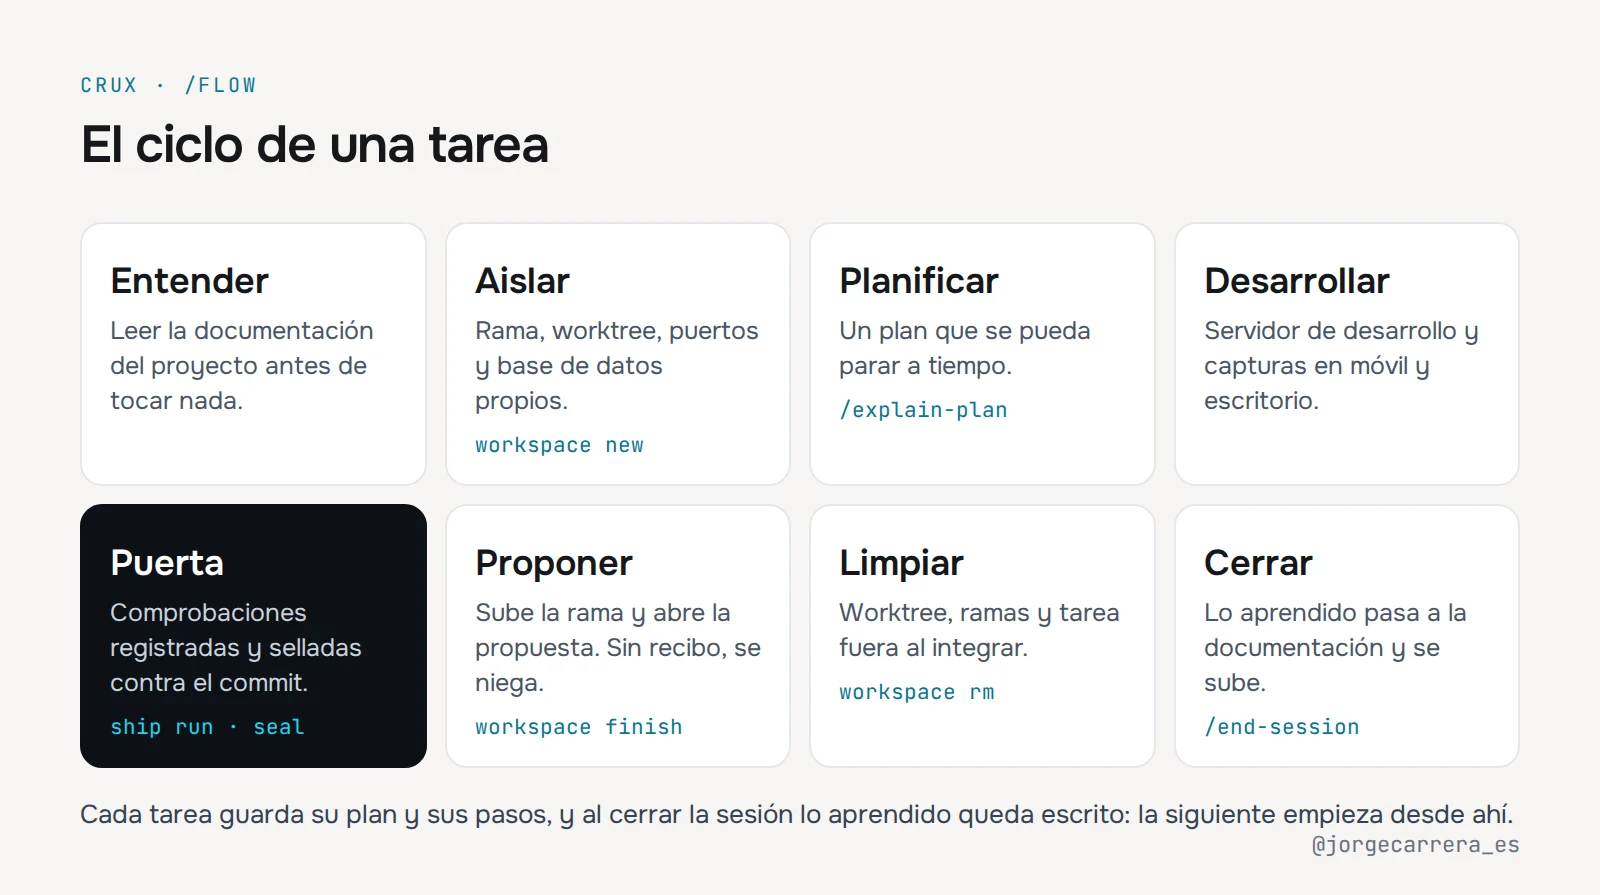
Toda tarea sigue el mismo recorrido, también las pequeñas.
Entender. Leer la documentación del proyecto antes de tocar nada.
Aislar. crux workspace new crea una rama y un worktree propios, reserva un
rango de puertos y separa la base de datos y el fichero de entorno. Así puedo
tener tres tareas del mismo repositorio en paralelo sin que se pisen.
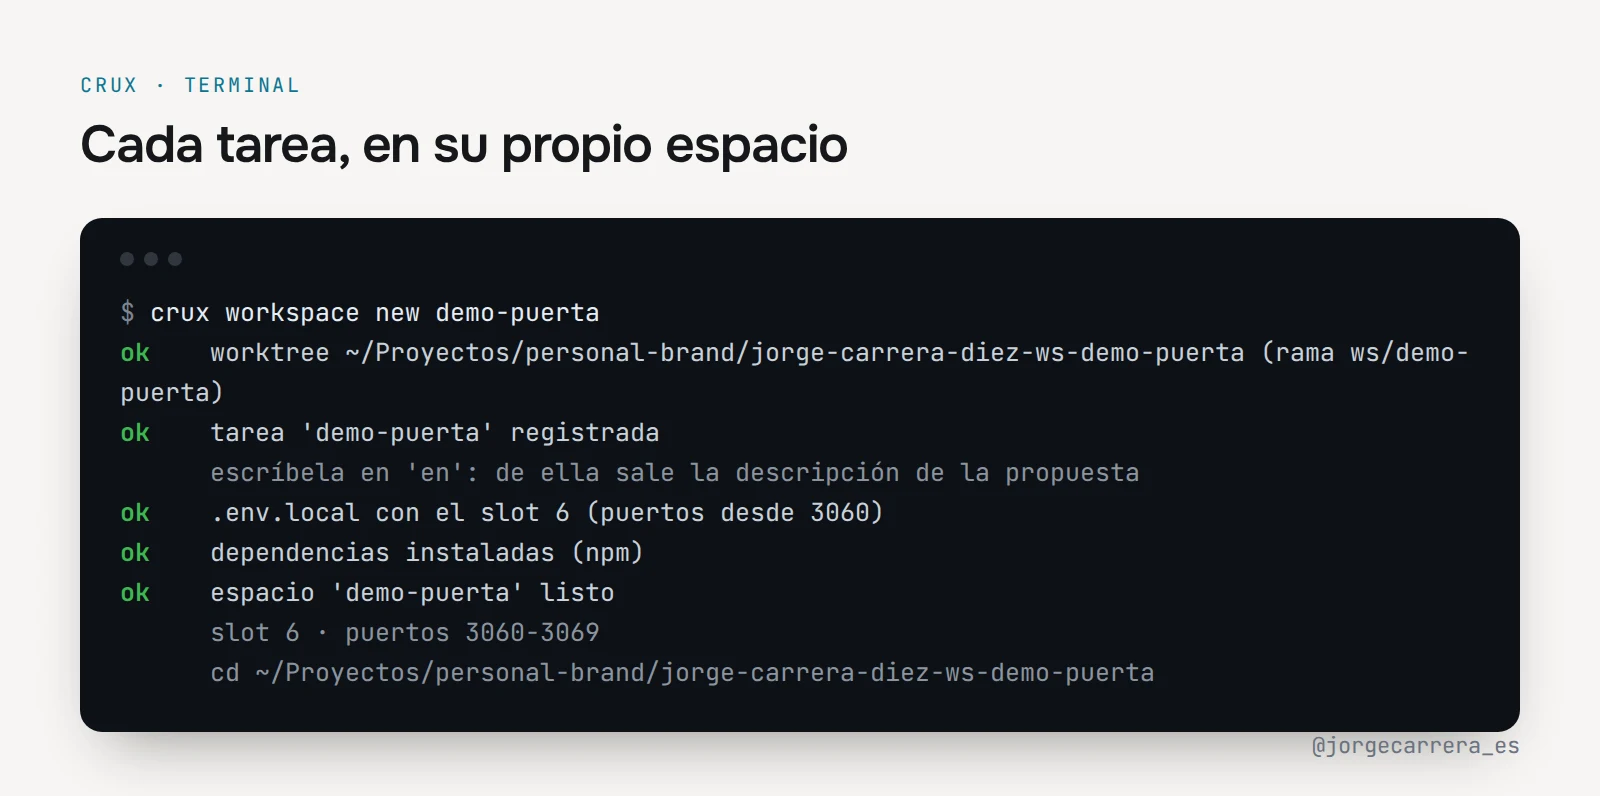
Cada tarea tiene además un registro con su plan y los pasos que se van dando. Si la dejo a medias, la siguiente sesión la retoma desde ahí.
Planificar. Si la tarea toca más de un módulo, el agente me presenta un plan antes de escribir código, con lo que comprobó y lo que se rompe si se equivoca, para que pueda pararlo a tiempo.
Desarrollar y pasar la puerta. El agente trabaja en el servidor de desarrollo, con capturas en móvil y en escritorio, y después pasa la puerta de calidad, que cuento más abajo.
Proponer. crux workspace finish sube la rama y abre la propuesta de
cambios.
Limpiar. Una vez integrada, se borran el worktree, la rama local, la remota y la tarea, sin que tenga que pedirlo.
Cerrar la sesión. Antes de terminar, el agente repasa la conversación y pasa a la documentación lo que merece quedarse: las decisiones que no se ven en el código, lo que conviene saber para no volver a tropezar y las reglas nuevas. Lo que ha aprendido de mí va a su memoria. Después comprueba que no se ha quedado nada desactualizado y lo sube todo. Así la siguiente sesión empieza sabiendo lo que se hizo en esta.
La puerta de calidad
Antes de un commit hay una cadena de comprobaciones: tests, lint, tipos, build, revisión del diff, convenciones, documentación afectada. Al principio pasaba los nueve pasos con cualquier cambio, incluso con una errata, y al ser tan caro acababa saltándomelos.
Ahora un script clasifica el diff y decide qué comprobaciones aplican. Un cambio de documentación pasa tres. Uno que toca la interfaz pasa todas, incluida la revisión visual. Lo decide el script porque, a ojo, cualquier cambio parece pequeño y se acaba saltando justo la comprobación que hacía falta.
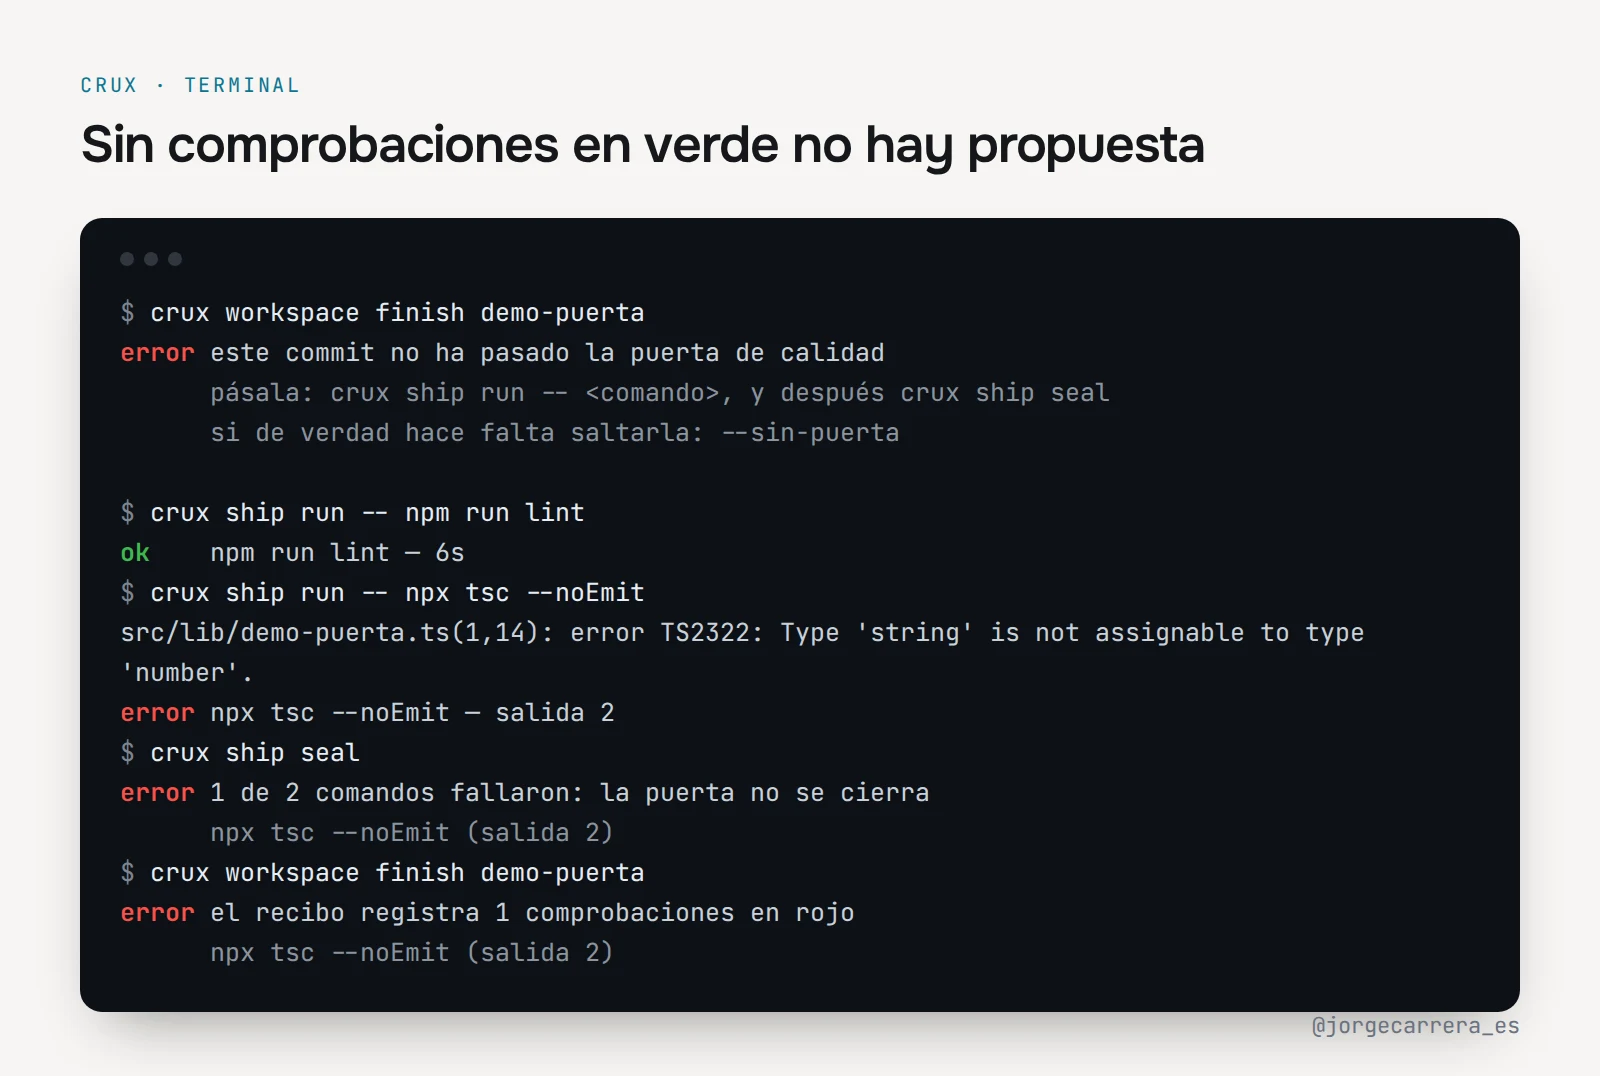
También cambió cómo se registra. Antes, el agente escribía el hash del commit
en un fichero después de decir que había verificado, y yo no tenía forma de
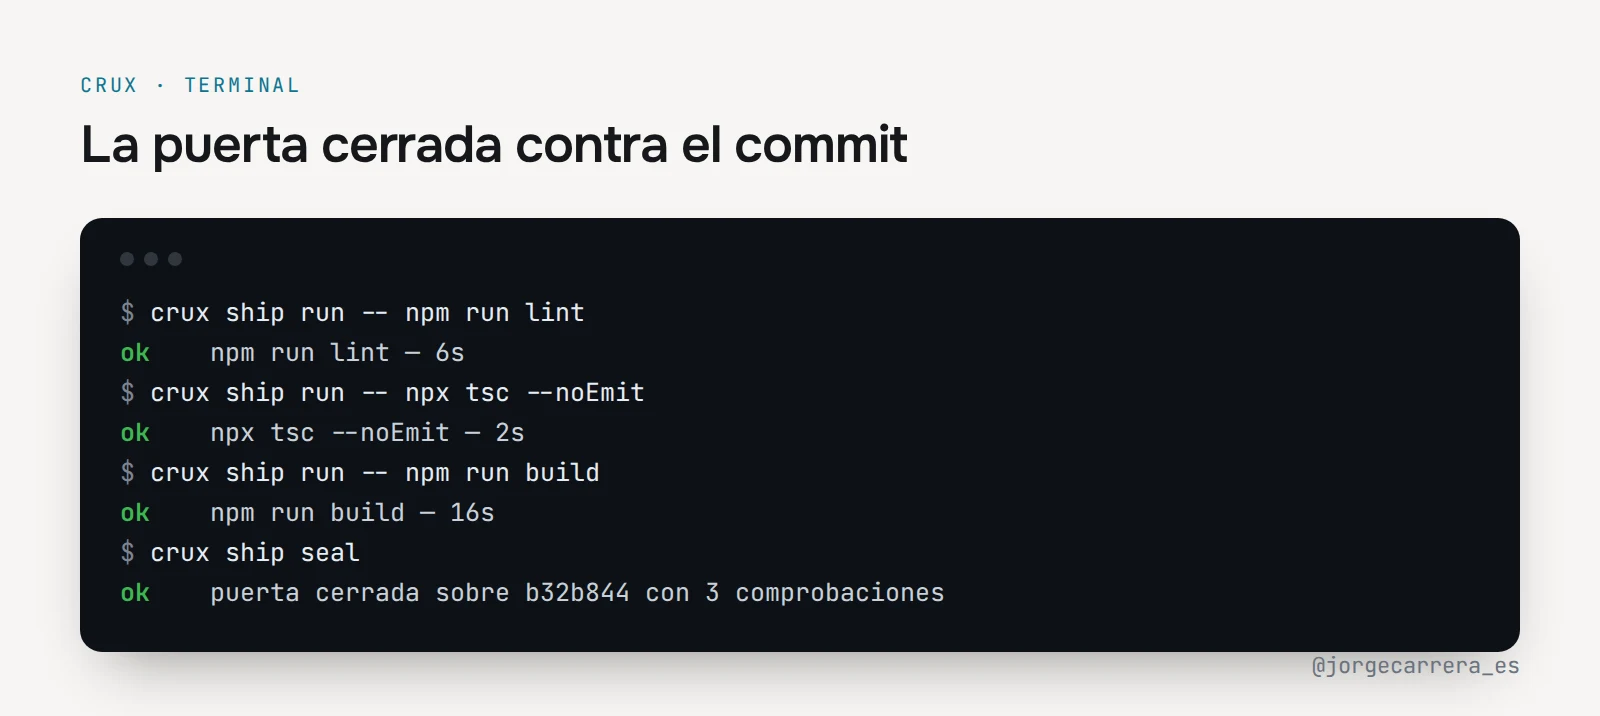
saber si lo había hecho de verdad. Ahora cada comprobación se ejecuta a través de crux ship run, que anota el
resultado real. crux ship seal cierra el recibo contra el commit actual. Y
crux workspace finish se niega a abrir la propuesta si no hay recibo, si
algo salió en rojo o si el commit ya no es el mismo.
Las reglas de cada proyecto también dejan de ser una recomendación. Cada
crux.json declara las suyas, y la puerta rechaza el cambio que las incumple.
Hay además hooks de git:
- Uno impide subir directamente a la rama principal.
- Otro rechaza el commit cuyo mensaje no está en el idioma del proyecto.
La puerta solo se puede saltar con una opción explícita, y solo cuando lo pido yo.
Los cambios visuales tienen un paso más, porque los tests no ven cómo queda la página. Antes de subir, el agente me enseña el antes y el después en móvil y en escritorio, y lo que se ve lo apruebo yo.
Cómo escribir skills que se usen
Tengo 44 en el kernel, y cada proyecto tiene además las suyas.
El agente no lee todas las skills antes de empezar, porque no le cabrían. Solo ve una descripción corta de cada una y decide por ella cuál abrir. Si la descripción se limita a contar qué hace la skill, el agente no la relaciona con la tarea que tiene delante. Por eso cada descripción dice en qué situaciones hace falta y con qué palabras suele aparecer el problema, que es justo lo que el agente compara.
Además, un agente juzga mal su propio trabajo. Si le pido que revise si un texto suena a IA, lo suele dar por bueno, porque no ve sus propios tics. Así que, cuando algo se puede medir, la skill trae un script que lo mide y el agente solo tiene que ejecutarlo. La revisión de textos cuenta los giros típicos de un texto generado, y la puerta de calidad clasifica el diff para decidir qué hay que comprobar.
También hay que decidir dónde vive cada skill. Algunas sirven para cualquier proyecto, como la de depurar un error o la de escribir tests. Otras solo tienen sentido en uno, como la de desplegar Snowy en su servidor. Para distinguirlas tapo los nombres propios: si el procedimiento sigue teniendo sentido sin ellos, es general y va al kernel. Los datos concretos, como las rutas o el servidor, quedan en un adaptador pequeño dentro del proyecto.
Por último, crux usage cuenta cuántas veces se usa cada skill. Si una no se
abre en un mes, o la descripción está mal escrita o la skill sobra, y la arreglo
o la quito.
Qué viene ahora
Crux sigue creciendo casi cada semana, normalmente a raíz de algo que echo en falta mientras trabajo.
Si veo que a más gente le interesa y le puede ayudar, me plantearé abrirlo. Estoy seguro de que, entre varios, quedaría bastante mejor de lo que puedo dejarlo yo solo.
Mientras tanto, nos seguimos leyendo aquí y en X, donde estoy como @jorgecarrera_es. Si trabajas con agentes o estás montando algo parecido, me encantará saber cómo lo haces.